Orquestación de Pipelines en la Era Agéntica: Cómo Apache Airflow Garantiza Datos AI-Ready en la Empresa
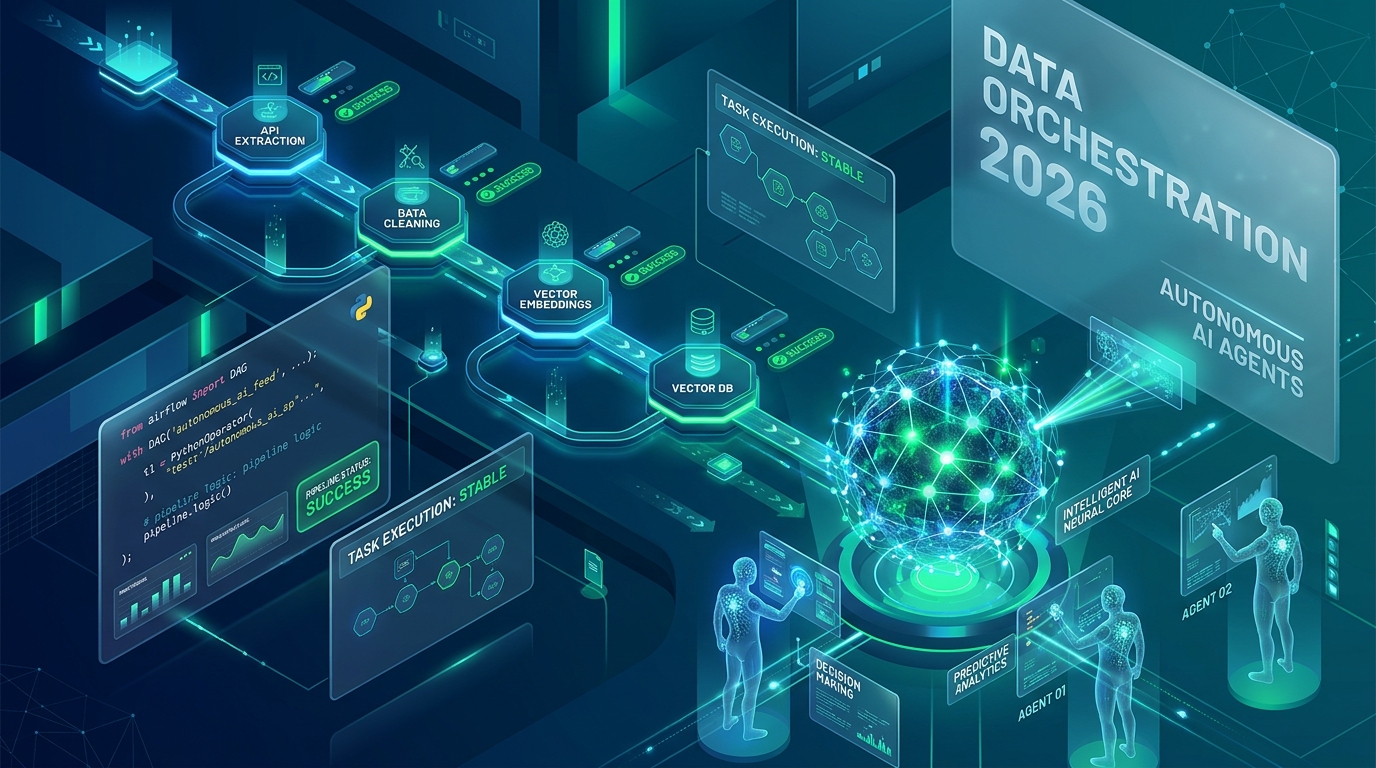
En 2026, el éxito de la inteligencia artificial agéntica en el entorno corporativo no depende de la sofisticación de los LLM, sino de la frescura, calidad y latencia de los datos que los alimentan. Apache Airflow se ha consolidado como el estándar industrial indiscutible para orquestar pipelines de datos ETL/ELT mediante código Python. Con la previsión de gasto en infraestructura de IA alcanzando los 521.000 millones de dólares según IDC, las organizaciones necesitan convertir sus arquitecturas de datos en flujos resilientes, tolerantes a fallos y escalables. Este artículo analiza cómo Apache Airflow elimina el cuello de botella del dato AI-Ready, ofrece un mini-tutorial para construir un DAG funcional en menos de 30 minutos y detalla la ruta de especialización bonificable por FUNDAE a través del programa Airflow Profesional de AEDIA.
En resumen
- El nuevo paradigma del dato: Los agentes de IA autónomos (como GPT-6 Cyber o Claude Code) exigen datos vectorizados y limpios en tiempo real; los scripts programados con cron ya no son suficientes.
- Estándar industrial: Apache Airflow permite definir flujos de trabajo como código (Data Pipelines as Code) en Python, garantizando trazabilidad, reintentos automáticos y modularidad.
- Caso de uso agéntico: Un pipeline de datos mal orquestado provoca alucinaciones en modelos LLM y errores de ejecución en decisiones de negocio automatizadas.
- Tutorial práctico: Guía paso a paso para desplegar un DAG (Grafo Acíclico Dirigido) en Python que ingesta, limpia y carga datos listos para consumo por agentes de IA.
- Capacitación profesional: El Curso de Airflow Profesional de AEDIA ofrece una titulación práctica 100% bonificable para empresas a través del crédito de formación FUNDAE.
La inteligencia artificial generativa y agéntica ha dejado de ser una simple herramienta de interacción mediante chat para convertirse en el motor operativo de las empresas líderes en 2026. Sin embargo, la adopción masiva de modelos autónomos ha destapado una verdad incómoda en los departamentos de tecnología: un agente de IA es tan preciso y fiable como la tubería de datos (pipeline) que lo alimenta.
Recientemente, IDC publicó que el gasto mundial en infraestructura de IA crecerá un 53% hasta alcanzar los 521.000 millones de dólares en 2026. Al mismo tiempo, figuras históricas del sector como Bill Gates señalan abiertamente que la programación manual tradicional está dando paso a roles centrados en la supervisión, arquitectura y orquestación de sistemas de IA. En este contexto, el verdadero diferencial competitivo para los ingenieros de datos, arquitectos de software y Tech Leads en España ya no radica en escribir consultas SQL ad-hoc, sino en desplegar sistemas de orquestación de datos resilientes capaces de entregar información AI-Ready sin latencia ni cuellos de botella.
Aquí es donde Apache Airflow se posiciona como la herramienta imprescindible. Desarrollado originalmente por Airbnb y mantenido por la Apache Software Foundation, Airflow permite programar, supervisar y orquestar workflows complejos utilizando código Python. Si tu empresa busca escalar el uso de modelos agénticos o actualizar la infraestructura de datos de su departamento informático, la formación especializada mediante un curso apache airflow profesional online bonificado representa la inversión estratégica más rentable de la temporada.
El nuevo cuello de botella de la IA: por qué los agentes autónomos exigen flujos ETL resilientes
Durante años, los departamentos de Inteligencia de Negocio (BI) operaron con cargas de datos nocturnas mediante tareas programadas simples (cron jobs). Si un proceso fallaba a las 3:00 AM, el informe de ventas del equipo directivo se retrasaba un par de horas sin causar un cataclismo operativo. En 2026, esa tolerancia a la latencia y al fallo ha desaparecido por completo.
Los agentes de IA corporativos interactúan directamente con los clientes, gestionan inventarios en tiempo real, ejecutan operaciones financieras y auditan la ciberseguridad organizacional. Si el flujo de ingesta de datos que alimenta la base de datos vectorial del agente se detiene o introduce registros corruptos, la IA tomará decisiones erróneas a gran velocidad. Este fenómeno se conoce como el efecto de alucinación por obsolescencia de datos.
Los retos del dato AI-Ready en 2026
Heterogeneidad de las fuentes
Los modelos de IA no solo consumen tablas SQL relacionales; requieren archivos JSON, feeds de APIs de modelos como OpenAI o Anthropic, logs no estructurados, documentos PDF y bases de datos de vectores (Vector Databases como Pinecone, Qdrant o Milvus).
Trazabilidad y Linaje de Datos
Ante regulaciones estrictas como el AI Act europeo, las empresas deben certificar exactamente qué datos nutrieron la decisión tomada por un agente autónomo en un instante determinado.
Manejo Dinámico de Dependencias
Un proceso de incrustación de texto (embeddings) no puede ejecutarse si el paso previo de limpieza de caracteres no ha finalizado con éxito en el cluster de procesamiento.
Apache Airflow resuelve estos desafíos transformando la gestión de datos en ingeniería de software pura. Al utilizar DAGs (Grafo Acíclico Dirigido) escritos en Python, los equipos de IT obtienen una visibilidad total sobre la ejecución de sus pipelines, alertas en tiempo real vía Slack o Microsoft Teams ante fallos de conexión, y la capacidad de reintentar automáticamente cualquier tarea fallida sin intervenir manualmente.
[ Extracción de API ] ───> [ Limpieza & Validaciones ] ───> [ Generación Embeddings ] ───> [ Carga en Vector DB ]
        │                                                                                        │
        └── (Fallo de Red) ──> [ Reintento Automático Airflow ] ─────────────────────────────────┘
Diseño e implementación práctica de DAGs en Python para automatizar procesos de datos
Un DAG (Directed Acyclic Graph) es una colección de tareas ordenadas donde cada nodo representa un paso del proceso y las aristas representan las dependencias entre ellos. Es “dirigido” porque tiene un sentido de flujo claro y “acíclico” porque no contiene bucles infinitos.
A continuación, presentamos un mini-tutorial técnico para que en menos de 30 minutos comprendas la estructura fundamental de un pipeline en Apache Airflow 2.x diseñado para alimentar un pipeline de IA.
Mini-Tutorial: Creación de un DAG de Ingesta y Limpieza en 4 Pasos
1Paso 1: Configurar el entorno e importar los módulos de Airflow
Para comenzar, necesitamos importar la clase DAG y los operadores necesarios. En la arquitectura moderna de Airflow, el uso del decorador @task (TaskFlow API) simplifica enormemente la sintaxis en Python.
from datetime import datetime, timedelta
from airflow.decorators import dag, task

# Definición de argumentos por defecto para el DAG
default_args = {
    'owner': 'equipo_data_aedia',
    'depends_on_past': False,
    'email_on_failure': True,
    'email': ['alertas-data@empresa.com'],
    'retries': 2,
    'retry_delay': timedelta(minutes=5),
}2Paso 2: Declarar la estructura general del DAG
Utilizamos el decorador @dag para definir la frecuencia de ejecución, la fecha de inicio y las propiedades de concurrencia.
@dag(
    dag_id='pipeline_ingesta_ai_ready',
    default_args=default_args,
    description='Pipeline de extracción y preparación de datos para agentes de IA',
    schedule_interval='@hourly',
    start_date=datetime(2026, 1, 1),
    catchup=False,
    tags=['ai', 'etl', 'aedia'],
)
def pipeline_ingesta_ai_ready():3Paso 3: Construir las tareas de Extracción, Transformación y Carga (ETL)
Definimos las funciones Python que representan cada fase del flujo de datos.
    @task()
    def extraer_datos_raw() -> list:
        """Simula la extracción de registros no estructurados desde una API externa."""
        datos_brutos = [
            {"id": 101, "texto": " Consulta sobre facturación de clientes ", "categoria": "finanzas"},
            {"id": 102, "texto": " Error de acceso al servidor cloud ", "categoria": "it"},
        ]
        return datos_brutos

    @task()
    def limpiar_y_estructurar(datos: list) -> list:
        """Limpia espacios en blanco y normaliza el texto para el modelo de IA."""
        datos_limpios = []
        for item in datos:
            texto_normalizado = item["texto"].strip().lower()
            datos_limpios.append({
                "id": item["id"],
                "texto_clean": texto_normalizado,
                "categoria": item["categoria"].upper()
            })
        return datos_limpios

    @task()
    def cargar_en_vector_db(datos_procesados: list):
        """Carga los datos en la base de datos lista para el consumo por el agente."""
        print(f"Cargando exitosamente {len(datos_procesados)} registros formateados en la base de datos de IA.")

    # Flujo de dependencias
    raw_data = extraer_datos_raw()
    clean_data = limpiar_y_estructurar(raw_data)
    cargar_en_vector_db(clean_data)

# Instanciación del flujo de trabajo
dag_pipeline = pipeline_ingesta_ai_ready()4Paso 4: Despliegue y verificación en la Web UI
- Guarda el código anterior en el directorio
dags/de tu instalación local o en la nube de Apache Airflow. - Inicia el planificador (Scheduler) y el servidor Web (Webserver) mediante
airflow standaloneo mediante Docker Compose. - Abre la consola web en
http://localhost:8080, busca el identificadorpipeline_ingesta_ai_readyy activa el interruptor a ON. - Comprueba cómo el grafo se ejecuta secuencialmente pasando los estados de queued a running y finalmente a success (verde claro).
Monitoreo, gestión de fallos y escalabilidad de tareas en entornos multi-cloud
Llevar Apache Airflow a producción en un entorno corporativo exige ir más allá de la ejecución en un servidor local. En 2026, la infraestructura cloud se distribuye entre servicios gestionados como Amazon MWAA (Managed Workflows for Apache Airflow), Google Cloud Composer o entornos Kubernetes a través de Helm Charts.
| Característica | Scripts Tradicionales (Cron) | Apache Airflow 2.x Corporativo |
|---|---|---|
| Definición de Tareas | Scripts bash aislados | Código Python modular (Data as Code) |
| Visibilidad | Archivos de log dispersos | Interfaz UI web centralizada en tiempo real |
| Manejo de Errores | Requiere intervención humana | Reintentos automáticos, backfilling y alertas |
| Escalabilidad | Limitada al hardware del servidor | Horizontal mediante Celery, Kubernetes o Executors Cloud |
| Integración con IA | Compleja y sin gobernanza | Soporte nativo para conectores de OpenAI, Snowflake y Vector DBs |
Estrategias avanzadas de escalabilidad para entornos agénticos
1. KubernetesExecutor para cargas de trabajo masivas
Permite que cada tarea del DAG cree un pod dinámico de Kubernetes de forma independiente. Si tu modelo necesita procesar 50.000 documentos PDF para convertirlos en vectores, Airflow escalará los pods en paralelo y los destruirá al finalizar, optimizando al máximo los costes de infraestructura.
2. Gestión segura de credenciales (Airflow Connections)
NUNCA almacenes claves de API de OpenAI, credenciales de AWS o contraseñas de bases de datos dentro del código Python. Airflow integra conectores nativos emparejados con gestores de secretos como HashiCorp Vault, AWS Secrets Manager o Azure Key Vault.
3. Alertas proactivas mediante SLA (Service Level Agreements)
Si la actualización del índice de vectores de tu empresa tarda más de 15 minutos, Airflow puede enviar una notificación automática al canal de guardia de DevOps para evitar descuidos antes de que los usuarios noten degradación en el servicio de la IA.
Evoluciona tu perfil técnico: la sinergia entre Airflow, Data Engineering y la Certificación SDD
El mercado laboral para ingenieros senior y líderes tecnológicos ha sufrido un giro drástico. La capacidad de escribir código de forma aislada se ha democratizado mediante herramientas de IA agéntica. Hoy en día, la verdadera ventaja profesional reside en la arquitectura, la orquestación y el control de calidad.
Dominar Apache Airflow te posiciona en la cúspide de la demanda de talento en ingeniería de datos. Para construir sistemas agénticos avanzados sin fisuras, es crucial combinar la orquestación de datos con disciplinas complementarias de alto impacto:
Ingeniería de Datos Avanzada
Profundiza en arquitecturas Lakehouse y procesamiento distribuido. Consulta nuestro catálogo completo en la sección de Master en Ingeniería de Datos.
Desarrollo Guiado por Especificación (SDD)
Al construir DAGs y pipelines de IA, sustituye la improvisación por especificaciones técnicas estructuradas. Descubre cómo certificar a tu equipo técnico en el Bootcamp AI Engineer de AEDIA.
Preguntas frecuentes (FAQ)
¿Es necesario ser desarrollador Senior en Python para realizar el curso de Airflow?
No. Se requieren conocimientos intermedios de programación orientada a objetos en Python y conceptos básicos de SQL. El programa está diseñado para que ingenieros de software, analistas de datos, DevOps y administradores de sistemas realicen una transición fluida hacia la orquestación profesional.
¿Qué diferencia existe entre un planificador clásico como Cron y Apache Airflow?
Cron se limita a ejecutar comandos a horas fijas sin conocer si la tarea previa falló o si existen dependencias entre distintos servidores. Apache Airflow es un orquestador dinámico que maneja grafos de dependencias complejas, reintentos automáticos, métricas visuales y escalado en la nube.
¿Cómo se tramita la bonificación FUNDAE para el curso de Airflow en empresas?
Todas las empresas con plantilla asalariada en España disponen de un crédito anual de formación continua ante la Fundación Estatal para la Formación en el Empleo (FUNDAE). En AEDIA gestionamos íntegramente los trámites administrativos sin coste adicional para que tu empresa aproveche el 100% de la bonificación sobre este programa formativo.
¿El curso cubre la integración de Airflow con servicios cloud como AWS o GCP?
Sí. El temario aborda el despliegue de Apache Airflow en entornos multi-cloud, el uso de proveedores oficializados (Airflow Providers) para AWS, Google Cloud y Azure, y la integración con bases de datos vectoriales para soluciones de inteligencia artificial agéntica.
Paso a paso para especializar a tu departamento informático con el programa Airflow Profesional de AEDIA
En un entorno empresarial hipercompetitivo donde los presupuestos de infraestructura de IA crecen a un ritmo del 53% anual, las empresas no pueden permitirse el lujo de mantener datos aislados o pipelines propensos a fallos imprevistos. Formar a tu equipo técnico en la orquestación de workflows es la decisión organizativa con mayor retorno sobre la inversión (ROI).
El Curso de Airflow Profesional de AEDIA se imparte en modalidad 100% online flexible, estructurado en casos prácticos extraídos de entornos de producción reales. A lo largo del programa, los alumnos aprenden a diseñar, desplegar y mantener arquitecturas de pipelines preparadas para los desafíos de la IA agéntica en 2026.
¿Por qué elegir el programa formativo de AEDIA?
Integración directa entre pipelines de datos y modelos de lenguaje de última generación.
Aprende directamente de arquitectos de datos y Tech Leads que gestionan diariamente plataformas en entornos multinacionales.
Formación financiada para empresas registradas en España mediante la gestión simplificada de su crédito acumulado.
Desarrolla un ecosistema de DAGs funcional y aplicable a los sistemas de tu propia empresa desde la primera semana.
No dejes que los datos de tu empresa sigan siendo el cuello de botella de tus soluciones de inteligencia artificial. Garantiza la resiliencia de tus pipelines de datos y especializa a tu equipo técnico.
Inscríbete hoy en el Curso de Airflow Profesional de AEDIA y bonifica la formación de tu empresaFuentes y lecturas recomendadas
- AEDIA (Curso de Airflow Profesional Bonificable)(aedia.es)
- MuyComputerPro (Gasto mundial en infraestructura de IA crece un 53% hasta 521.000 M$ en 2026)(muycomputerpro.com)
- Infobae (Declaraciones de Bill Gates sobre la evolución de la programación e IA)(infobae.com)
Comparte en LinkedIn
🚀 En 2026, un agente de IA autónomo es tan fiable como el pipeline de datos que lo alimenta. Con el gasto global en infraestructura de IA alcanzando los 521.000 millones de dólares (IDC), el verdadero cuello de botella corporativo ya no es el modelo LLM, sino entregar datos 'AI-Ready' limpios, vectorizados y sin latencia. En nuestra nueva guía técnica analizamos: 🔹 Por qué los antiguos cron jobs provocan alucinaciones por obsolescencia de datos en agentes autónomos. 🔹 Mini-tutorial en Python: Cómo crear un DAG en Apache Airflow 2.x con TaskFlow API (@dag y @task) en 4 pasos. 🔹 Escalabilidad multi-cloud con KubernetesExecutor, gestión de secretos y alertas SLA. 🔹 Cómo especializar a tu departamento IT con el Curso de Airflow Profesional de AEDIA (100% bonificable por FUNDAE). Lee el artículo y el tutorial completo aquí 👉 https://aedia.es/blog/orquestacion-pipelines-apache-airflow-datos-ai-ready #ApacheAirflow #DataEngineering #IAAgentica #Python #ETL #VectorDB #FUNDAE #AEDIA
Compartir ahora