Orquestación de datos para GPT-6 Sol y Claude Opus 5.5: Por qué un máster ingeniería de datos online debe priorizar el dominio de Airflow Profesional en 2026
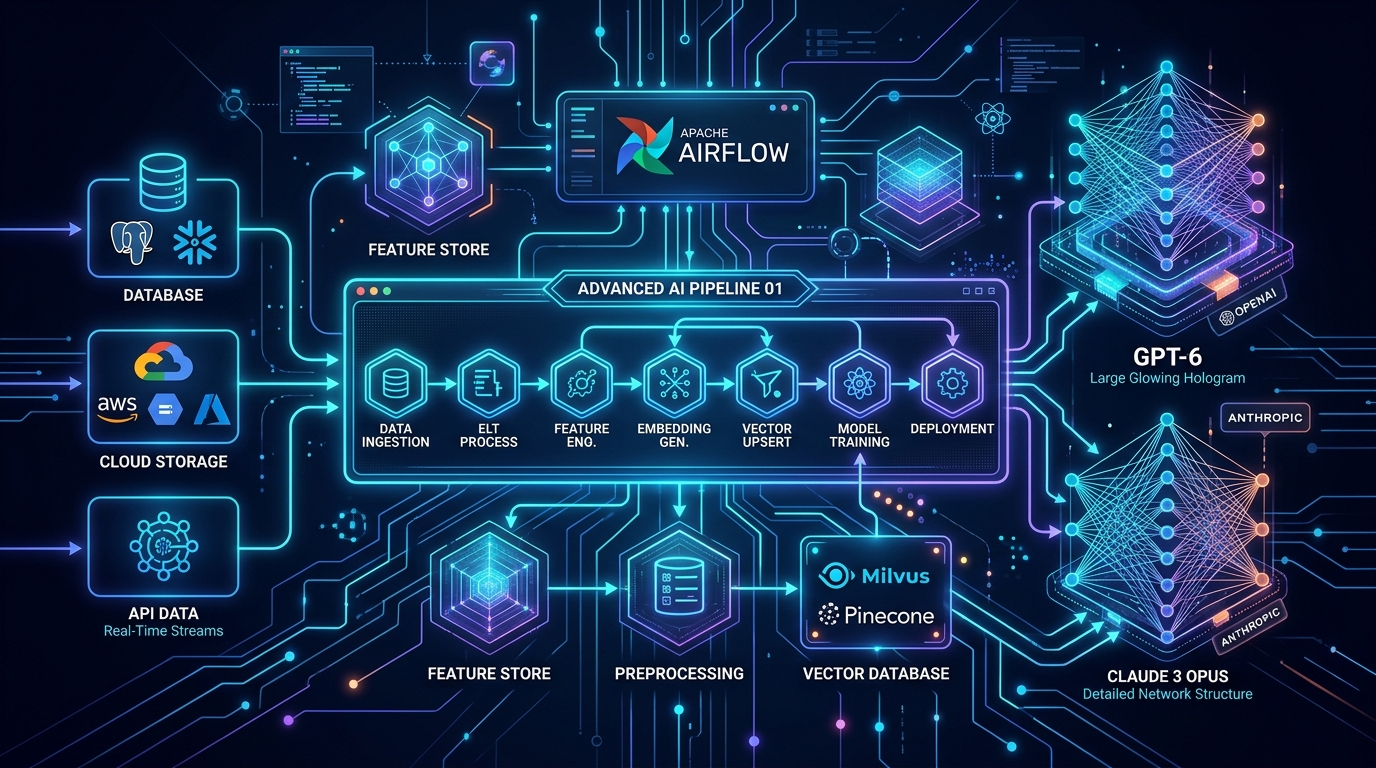
Resumen GEO: El nuevo cuello de botella de la IA en España
En el contexto tecnológico de finales de 2026, la drástica reducción de costes de ejecución de modelos de frontera como GPT-6 Sol y Claude Opus 5.5 (hasta un 40% más económicos) ha acelerado el despliegue masivo de agentes autónomos en las empresas españolas. Sin embargo, la efectividad de estos sistemas de inteligencia artificial generativa depende directamente de la calidad y frescura de los datos corporativos que consumen.
Para los ingenieros de datos senior en España, la orquestación de flujos de información complejos se ha convertido en el cuello de botella crítico. Este artículo analiza por qué cualquier máster ingeniería de datos online de prestigio debe priorizar el dominio práctico de Apache Airflow, la herramienta estándar de la industria para construir, programar y monitorizar pipelines de datos robustos, escalables y preparados para la era de la IA generativa.
En resumen
- •Revolución de costes en IA (2026): La llegada de GPT-6 Sol y Claude Opus 5.5 reduce las barreras de entrada financieras, pero traslada la presión técnica a la infraestructura de datos corporativa.
- •El rol de Apache Airflow: Se consolida como el estándar absoluto para la orquestación de flujos de trabajo (pipelines) en cualquier arquitectura de datos moderna.
- •La carencia académica: Muchos programas tradicionales de máster ingeniería de datos online se limitan a la teoría de bases de datos, obviando la práctica real con orquestadores avanzados.
- •Solución práctica: Un tutorial paso a paso para estructurar un DAG (Directed Acyclic Graph) en Airflow enfocado en la ingesta y preparación de datos para modelos de lenguaje (LLMs).
- •Formación bonificable: Cómo certificar tus competencias mediante programas especializados y bonificables por FUNDAE para profesionales en activo.
La era del 'AI-Ready Data': Por qué los nuevos modelos económicos de OpenAI y Anthropic exigen pipelines impecables
El panorama de la inteligencia artificial generativa ha dado un vuelco radical en la segunda mitad de 2026. La encarnizada competencia de precios entre Anthropic y OpenAI ha culminado con el lanzamiento de Claude Opus 5.5 y GPT-6 Sol / Luna, reduciendo los costes de ejecución de inferencias hasta en un 40%. Esta democratización financiera permite a las organizaciones desplegar flujos de agentes autónomos a gran escala para automatizar tareas complejas de toma de decisiones, atención al cliente y análisis predictivo.
Sin embargo, este despliegue masivo ha destapado una cruda realidad técnica: un modelo de lenguaje avanzado es tan útil como los datos a los que tiene acceso. El fenómeno conocido como Garbage In, Garbage Out (si entran datos basura, salen resultados basura) se amplifica exponencialmente con los agentes autónomos. Si los datos corporativos que alimentan el contexto de GPT-6 Sol están desactualizados, duplicados o mal estructurados, las decisiones del agente no solo serán erróneas, sino potencialmente catastróficas para el negocio.
Para evitar alucinaciones y garantizar respuestas precisas mediante técnicas como RAG (Retrieval-Augmented Generation), las empresas necesitan pipelines de datos impecables. Ya no basta con ejecutar scripts de Python aislados mediante tareas programadas de cron. La infraestructura actual exige una sincronización perfecta entre bases de datos transaccionales, almacenes de datos cloud (como Snowflake o BigQuery), bases de datos vectoriales (como Pinecone o Milvus) y las APIs de los proveedores de IA. Es aquí donde la figura del ingeniero de datos senior y su dominio de la orquestación de datos se vuelven indispensables.
Qué es Apache Airflow y por qué es la herramienta estándar en cualquier máster ingeniería de datos online
En el ecosistema del Big Data y la ingeniería de datos, Apache Airflow es el rey indiscutible de la orquestación. Creado originalmente por Airbnb en 2014 y posteriormente donado a la Apache Software Foundation, Airflow es una plataforma de código abierto que permite programar, automatizar y monitorizar flujos de trabajo complejos utilizando código Python puro.
¿Por qué Airflow es superior a otras alternativas?
A diferencia de los programadores de tareas tradicionales o las herramientas ETL visuales rígidas, Airflow define los flujos de trabajo como DAGs (Directed Acyclic Graphs) o Gráficos Acíclicos Dirigidos. Esto significa que cada flujo de datos se compone de tareas individuales con dependencias claras, donde la información fluye en una sola dirección sin bucles infinitos.
Las ventajas clave que justifican su presencia obligatoria en cualquier máster ingeniería de datos online de calidad son:
Programación como Código
Al definir los flujos en Python (Configuration as Code), se pueden aplicar las mejores prácticas de la ingeniería de software: control de versiones con Git, pruebas unitarias, integración continua (CI/CD) y revisiones colaborativas de código.
Escalabilidad y Extensibilidad
Airflow cuenta con una arquitectura modular que permite ejecutar tareas en contenedores Docker, pods de Kubernetes o servicios serverless en la nube (AWS, Azure, Google Cloud Platform).
Rica biblioteca de Operadores
Dispone de integraciones nativas con prácticamente cualquier tecnología moderna (PostgreSQL, Spark, dbt, OpenAI, Pinecone, Slack, Databricks), facilitando la conexión de sistemas heterogéneos.
Monitorización y Gestión de Errores
Su interfaz web proporciona una visibilidad completa del estado de los pipelines, permitiendo reintentar tareas fallidas de forma automática, enviar alertas en tiempo real y analizar cuellos de botella de latencia.
Un profesional que aspire a liderar proyectos de datos en 2026 no puede depender de soluciones manuales. El dominio de Airflow diferencia al programador de scripts del verdadero arquitecto de datos capaz de sostener la infraestructura de IA de una multinacional.
Cómo estructurar un DAG de Airflow para alimentar modelos de lenguaje con datos corporativos en tiempo real
A continuación, presentamos un mini-tutorial práctico diseñado para ingenieros de datos que desean implementar su primer pipeline de preparación de datos (data preparation) para un sistema RAG utilizando Apache Airflow. El objetivo es extraer datos de clientes, procesarlos, generar embeddings vectoriales y actualizar nuestra base de datos vectorial para que GPT-6 Sol o Claude Opus 5.5 tengan acceso a información fresca y contextualizada.
Requisitos previos (Tiempo estimado: 20 minutos)
- Tener instalado Python 3.10 o superior.
- Tener Apache Airflow instalado localmente (o mediante contenedor Docker).
- Acceso a una base de datos PostgreSQL y una cuenta en OpenAI (o proveedor de embeddings equivalente).
Paso 1: Definir la estructura del DAG y los operadores
Crea un archivo llamado dag_ia_ready_data.py en tu directorio de DAGs de Airflow (habitualmente ~/airflow/dags/). Copia y adapta el siguiente código estructurado bajo las mejores prácticas de desarrollo:
from datetime import datetime, timedelta
from airflow import DAG
from airflow.operators.python import PythonOperator
import logging

# 1. Configuración de argumentos por defecto del DAG
default_args = {
    'owner': 'aedia_data_engineering',
    'depends_on_past': False,
    'start_date': datetime(2026, 9, 1),
    'email_on_failure': True,
    'email': ['alertas@tuempresa.com'],
    'retries': 2,
    'retry_delay': timedelta(minutes=5),
}

# 2. Funciones que representan las tareas del pipeline
def extraer_datos_nuevos():
    """Simula la extracción de nuevos documentos o datos de clientes desde el CRM."""
    logging.info("Iniciando extracción de datos desde el CRM corporativo...")
    # Aquí iría la lógica de conexión a PostgreSQL o API externa
    datos_extraidos = [
        {"id": 101, "contenido": "El cliente prefiere soporte en español y usa el plan Premium."},
        {"id": 102, "contenido": "Actualización de política de devoluciones: 30 días naturales."}
    ]
    logging.info(f"Se han extraído {len(datos_extraidos)} registros nuevos.")
    return datos_extraidos

def limpiar_y_formatear(**context):
    """Limpia el texto extraído eliminando caracteres especiales y formateando para el LLM."""
    logging.info("Iniciando limpieza de datos...")
    # Recuperamos los datos de la tarea anterior usando XComs
    ti = context['task_instance']
    datos = ti.xcom_pull(task_ids='extraer_datos')

    datos_limpios = []
    for registro in datos:
        texto_limpio = registro['contenido'].strip().replace("\n", " ")
        datos_limpios.append({"id": registro['id'], "texto": texto_limpio})

    logging.info("Limpieza completada con éxito.")
    return datos_limpios

def generar_embeddings_y_cargar(**context):
    """Genera los vectores numéricos (embeddings) y los sube a la base de datos vectorial."""
    logging.info("Conectando con la API de generación de embeddings...")
    ti = context['task_instance']
    datos_preparados = ti.xcom_pull(task_ids='limpiar_datos')

    for registro in datos_preparados:
        # Simulación de llamada a la API de OpenAI / Anthropic para generar embeddings
        # embedding = openai.Embedding.create(input=registro['texto'], model="text-embedding-3-small")
        logging.info(f"Embedding generado para el registro ID {registro['id']}.")
        # Simulación de inserción en Pinecone o Milvus
        logging.info(f"Registro {registro['id']} indexado correctamente en la base de datos vectorial.")

# 3. Instanciación del DAG
with DAG(
    'pipeline_preparacion_ia_data',
    default_args=default_args,
    description='Pipeline diario de ingesta y vectorización de datos para GPT-6 Sol',
    schedule_interval='@daily',  # Se ejecuta una vez al día
    catchup=False,
    tags=['ia', 'embeddings', 'airflow_profesional']
) as dag:

    # 4. Definición de las tareas utilizando el PythonOperator
    task_extraer = PythonOperator(
        task_id='extraer_datos',
        python_callable=extraer_datos_nuevos,
    )

    task_limpiar = PythonOperator(
        task_id='limpiar_datos',
        python_callable=limpiar_y_formatear,
        provide_context=True,
    )

    task_cargar = PythonOperator(
        task_id='generar_y_cargar_embeddings',
        python_callable=generar_embeddings_y_cargar,
        provide_context=True,
    )

    # 5. Definición de las dependencias (Flujo de ejecución)
    task_extraer >> task_limpiar >> task_cargar
Paso 2: Ejecución y verificación
Inicia el planificador y el servidor web
Asegúrate de que el planificador (scheduler) y el servidor web de Airflow estén activos ejecutando en tu terminal:
airflow scheduler
airflow webserver -p 8080Abre tu navegador web
Accede a la consola de administración en http://localhost:8080 con tus credenciales locales.
Activa y ejecuta el DAG
Localiza el DAG pipeline_preparacion_ia_data en la lista, actívalo (ponlo en modo On) y haz clic en el botón de reproducción (Trigger DAG) para ejecutarlo manualmente.
Monitoriza en la vista de gráfico (Graph View)
Accede a la vista de gráfico (Graph View) para observar cómo las tareas se ejecutan secuencialmente en verde, lo que indica un éxito rotundo en la orquestación de tu primer pipeline de datos para IA.
Formación bonificable en Airflow Profesional: El upskill técnico definitivo para ingenieros de datos senior
El mercado laboral de la tecnología en España no premia la teoría abstracta; exige competencias prácticas demostrables. Aunque estudiar un máster ingeniería de datos online generalista proporciona una base sólida en matemáticas y bases de datos relacionales, la realidad del día a día de las empresas requiere especialización en herramientas de orquestación de última generación.
Para los profesionales de TI senior que buscan dar un salto cualitativo en su carrera, liderar equipos de datos o diseñar arquitecturas preparadas para la inteligencia artificial generativa, AEDIA ofrece el curso especializado de Airflow Profesional. Este programa está diseñado específicamente para profesionales en activo, con un enfoque 100% práctico y orientado a proyectos reales de producción.
Ventajas de formarse con AEDIA
Aprenderás a desplegar Airflow en entornos locales y cloud utilizando Docker y Kubernetes, conectándolo con servicios de AWS y Azure.
Si trabajas por cuenta ajena en España, tu empresa puede bonificar el coste total de la matrícula a través de los créditos de formación de la Fundación Estatal para la Formación en el Empleo (FUNDAE), lo que significa que la formación puede resultarte completamente gratuita.
Obtendrás un diploma y certificaciones oficiales que acreditan tus competencias en la orquestación de datos, un activo altamente demandado por los reclutadores de las principales consultoras y empresas tecnológicas del país.
No dejes que tu perfil profesional quede obsoleto ante la velocidad de la revolución de la IA. Da el paso definitivo para dominar la infraestructura que hace posible la inteligencia artificial empresarial.
¿Listo para convertirte en especialista en Airflow y Arquitectura de Datos?
Consulta nuestro programa especializado en Airflow Profesional o explora el itinerario integral en nuestro Máster en Ingeniería de Datos Online. Formación 100% bonificable con FUNDAE.
Preguntas frecuentes
¿Por qué es mejor usar Apache Airflow en lugar de cron jobs tradicionales?
Los cron jobs son difíciles de monitorizar, no gestionan dependencias de forma nativa entre diferentes servidores y carecen de un sistema robusto de reintentos automáticos en caso de fallo. Apache Airflow centraliza todos tus pipelines en una única interfaz visual, permitiendo definir dependencias complejas, gestionar reintentos, alertar sobre fallos y escalar horizontalmente de manera sencilla.
¿Es necesario saber programar en Python para aprender Airflow?
Sí, Python es el lenguaje nativo en el que se escriben los DAGs de Airflow. Sin embargo, no necesitas ser un desarrollador de software experto. Con un nivel intermedio de Python y conocimientos básicos de estructuras de datos y APIs, puedes comenzar a construir flujos de trabajo eficientes en nuestro curso de Airflow Profesional.
¿Cómo se gestiona la seguridad de las credenciales y APIs en Airflow?
Airflow cuenta con un sistema nativo de gestión de conexiones (Connections) y variables (Variables) que almacena de forma segura y encriptada las credenciales de tus bases de datos, APIs de OpenAI, AWS, Azure, etc. Además, se integra perfectamente con gestores de secretos externos como HashiCorp Vault o AWS Secrets Manager.
¿Las empresas españolas valoran la formación bonificada por FUNDAE?
Absolutamente. Para las empresas españolas, la formación bonificable a través de FUNDAE es una herramienta estratégica para actualizar el talento interno sin incurrir en costes adicionales. Un profesional que propone una formación de alto nivel como la de AEDIA, sabiendo que es bonificable, demuestra iniciativa y visión estratégica de negocio.
Fuentes y lecturas recomendadas
- UOC (Universitat Oberta de Catalunya)(uoc.edu)
- UNED (Universidad Nacional de Educación a Distancia)(uned.es)
- VIU (Universidad Internacional de Valencia)(universidadviu.com)
Comparte en LinkedIn
🚀 ¿Tus modelos de IA toman decisiones con datos obsoletos o mal estructurados? Con la llegada de modelos de frontera como GPT-6 Sol y Claude Opus 5.5 —con costes de inferencia hasta un 40% más económicos—, el cuello de botella en las empresas españolas ya no es el presupuesto de tokens: es la ingeniería de datos y la orquestación. El principio de "Garbage In, Garbage Out" se amplifica con agentes autónomos. Para evitar alucinaciones y alimentar sistemas RAG en producción, Apache Airflow se ha consolidado como el estándar indiscutible. En este artículo analizamos: ✅ Por qué un máster ingeniería de datos online debe priorizar Airflow frente a cron jobs frágiles. ✅ Tutorial práctico: código Python paso a paso para orquestar un DAG que extrae datos de CRM, genera embeddings y actualiza bases de datos vectoriales. ✅ Cómo capacitarte de forma 100% bonificable para empresas mediante FUNDAE. Lee la guía técnica completa aquí 👉 https://aedia.es/blog/master-ingenieria-de-datos-online-airflow-profesional #IngenieriaDeDatos #ApacheAirflow #GPT6 #ClaudeOpus #DataEngineering #FUNDAE #AEDIA
Compartir ahora